Один Docker образ, разные задачи: миграции, health checks и деплой в Compose и Kubernetes
Использование одного Docker-образа с разными CLI-командами для миграций, запуска приложения и health checks в Docker Compose и Kubernetes
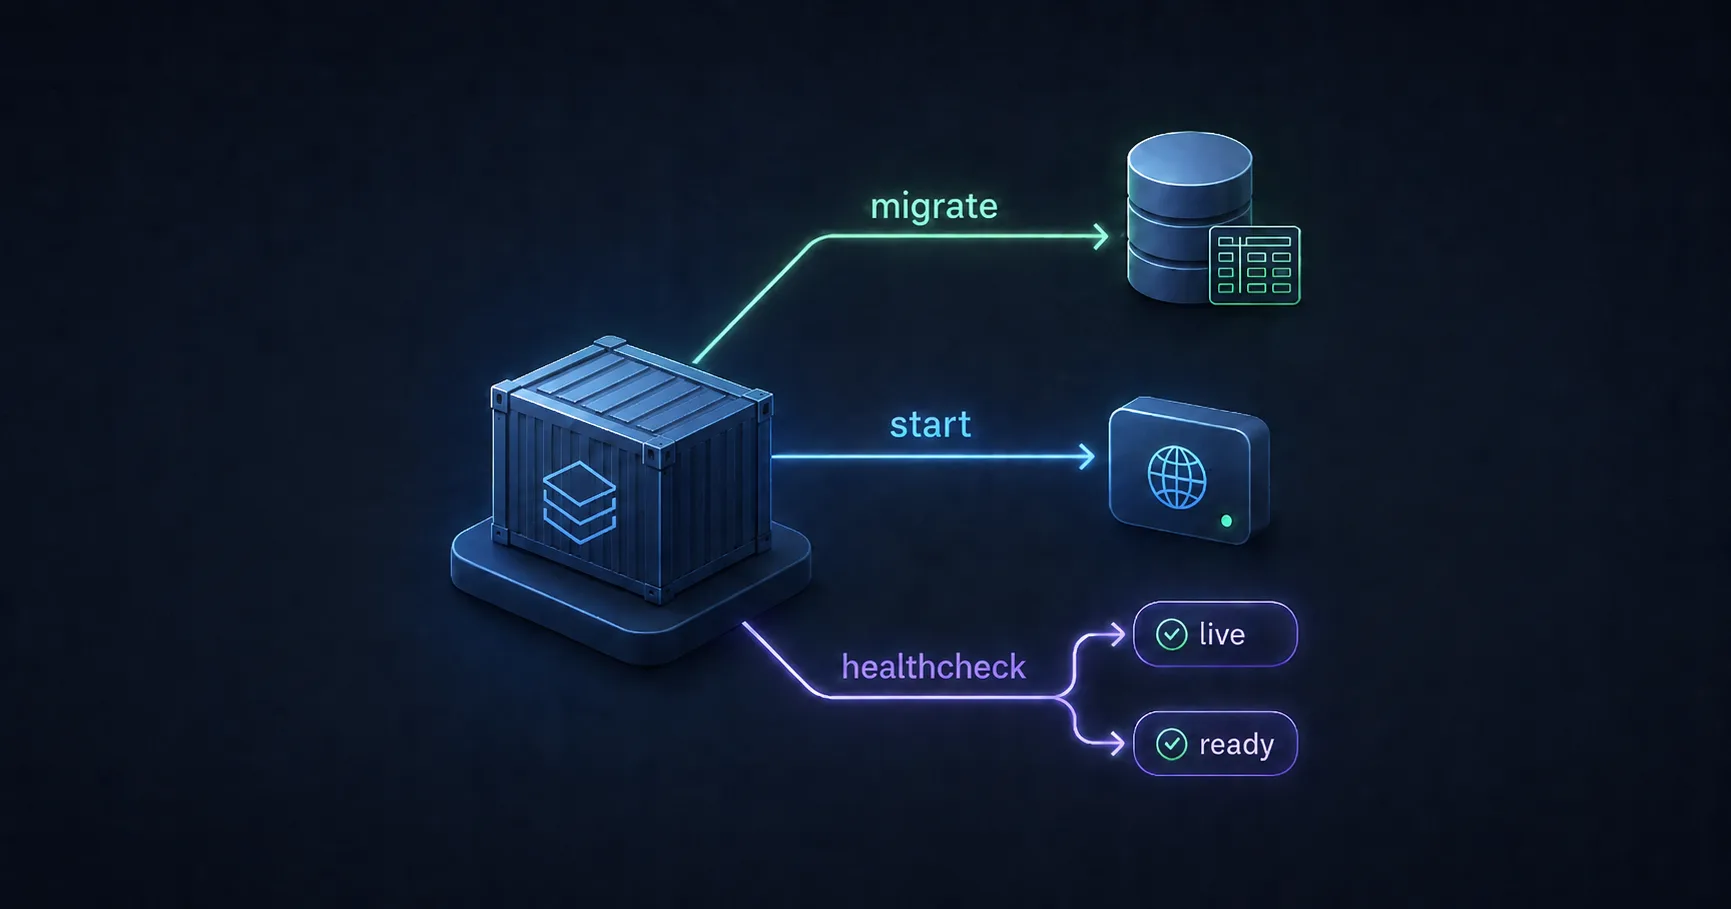
Один docker образ необязательно должен означать один сценарий запуска. На практике удобно собирать приложение один раз, а конкретную роль контейнера определять командой.
Например, один и тот же образ IAM-сервиса может поддерживать две команды:
iam migrateiam startmigrate выполняет миграции PostgreSQL и завершается, а start запускает долгоживущий HTTP-сервис.
Так миграции и само приложение используют один артефакт, но изменение схемы базы данных не становится скрытым побочным эффектом каждого запуска приложения.
Самый простой вариант — выполнять миграции внутри start:
start: migrate() runServer()Для локальной разработки это может казаться удобным. Но при нескольких репликах появляется неприятный вопрос: кто именно должен выполнять миграцию?
Если одновременно запускаются три экземпляра приложения, все три потенциально начинают менять одну и ту же схему. Даже если инструмент миграций умеет блокировки, жизненный цикл приложения становится сложнее: старт HTTP-сервера теперь зависит не только от его собственной инициализации, но и от состояния схемы базы данных.
Гораздо прозрачнее разделить операции:
image├── migrate└── startМиграция становится отдельным шагом деплоя:
- запустить контейнер с командой
migrate; - дождаться успешного завершения;
- запустить или обновить контейнеры с командой
start.
При этом код приложения, драйвер PostgreSQL, миграции и их версии остаются внутри одного образа. Не нужен отдельный migration image, который пришлось бы версионировать синхронно с приложением.
Для долгоживущего сервиса полезно разделить две проверки состояния.
GET /health/liveGET /health/ready/health/live отвечает на вопрос:
Жив ли сам процесс?
Он не обязан проверять все внешние зависимости. Если база данных временно недоступна, перезапуск процесса зачастую ничего не исправит.
/health/ready отвечает на другой вопрос:
Может ли этот экземпляр прямо сейчас обслуживать рабочий трафик?
Здесь уже имеет смысл проверить соединение с PostgreSQL и другие зависимости, без которых запросы всё равно завершатся ошибкой.
Получается примерно такая модель:
/health/live    └── процесс работает
/health/ready    ├── процесс работает    └── PostgreSQL доступен
Это различие особенно важно в Kubernetes. Неуспешная livenessProbe может привести к перезапуску контейнера, тогда как неуспешная readinessProbe просто исключает Pod из обслуживания трафика.
В Compose миграцию можно представить как короткоживущий сервис:
services:  iam-migrate:    image: userhub/iam:dev    command: ["migrate"]    environment:      DB_URL: ${DB_URL}    restart: "no"
  iam:    image: userhub/iam:dev    command: ["start"]    environment:      DB_URL: ${DB_URL}    depends_on:      iam-migrate:        condition: service_completed_successfully    healthcheck:      test: ["CMD", "/iam", "healthcheck"]      interval: 10s      timeout: 4s      retries: 5
Здесь важны две детали.
Во-первых, iam-migrate не является сервисом в привычном смысле. Контейнер должен применить миграции и завершиться с кодом 0.
Во-вторых, iam зависит не просто от запуска контейнера миграций:
condition: service_completed_successfullyCompose ждёт его успешного завершения и только после этого запускает IAM.
Если миграция завершилась ошибкой, приложение не стартует поверх схемы, состояние которой неизвестно.
Docker Compose умеет запускать healthcheck, но сам по себе не знает семантику HTTP-эндпоинтов приложения.
Поэтому бинарник может предоставить небольшую вспомогательную команду:
/iam healthcheckВнутри она обращается, например, к:
http://localhost:8080/health/readyи преобразует HTTP-ответ в обычный exit code:
0 — ready1 — not readyДля Compose этого достаточно, чтобы отметить контейнер как healthy или unhealthy.
У этого подхода есть ещё один плюс: в образ не нужно добавлять curl или wget только ради health check.
В Kubernetes жизненный цикл миграции естественно представить через Job.
apiVersion: batch/v1kind: Jobmetadata: name: iam-migrate-1-0spec: backoffLimit: 1 template: spec: restartPolicy: Never containers: - name: migrate image: userhub/iam:dev args: ["migrate"] env: - name: DB_URL valueFrom: secretKeyRef: name: iam-database key: urlJob использует тот же образ, что и приложение, но запускает другую команду:
args: ["migrate"]После успешного завершения миграции можно обновлять Deployment.
apiVersion: apps/v1kind: Deploymentmetadata:  name: iamspec:  replicas: 2
  selector:    matchLabels:      app: iam
  template:    metadata:      labels:        app: iam
    spec:      containers:        - name: iam          image: userhub/iam:dev          args: ["start"]
          ports:            - containerPort: 8080
          env:            - name: DB_URL              valueFrom:                secretKeyRef:                  name: iam-database                  key: url
          readinessProbe:            httpGet:              path: /health/ready              port: 8080
          livenessProbe:            httpGet:              path: /health/live              port: 8080
Здесь вспомогательная команда healthcheck уже не нужна. Kubernetes умеет самостоятельно выполнять HTTP-пробы.
readinessProbe определяет, можно ли направлять запросы в конкретный Pod:
readinessProbe: httpGet: path: /health/ready port: 8080А livenessProbe следит за тем, не оказался ли процесс в состоянии, из которого требуется перезапуск:
livenessProbe: httpGet: path: /health/live port: 8080В результате один и тот же артефакт проходит весь путь от CI до production:
userhub/iam:dev │ ├── migrate ──> PostgreSQL schema │ └── start ────> IAM serviceЭто даёт несколько полезных свойств.
Версия миграций совпадает с версией приложения. Нельзя случайно запустить мигратор от одной версии и приложение от другой, если pipeline везде использует один image tag.
Не появляется второй Dockerfile и второй образ, жизненный цикл которого нужно поддерживать.
При этом ответственность остаётся разделённой: migrate меняет схему и завершается, start обслуживает запросы, /health/live сообщает о состоянии процесса, а /health/ready — о способности принимать трафик.
Главная идея здесь не столько в Docker или Kubernetes, сколько в явном жизненном цикле приложения:
artifact │ ├── migrate │ └── exit │ └── start ├── /health/live └── /health/readyОдин образ может выполнять несколько задач. Важно лишь не смешивать эти задачи внутри одного запуска.